
七个平台的帖子、评论、创作者主页都能抓,免 JS 逆向。做选题调研真趁手,官方禁商用,搬运路线别碰。
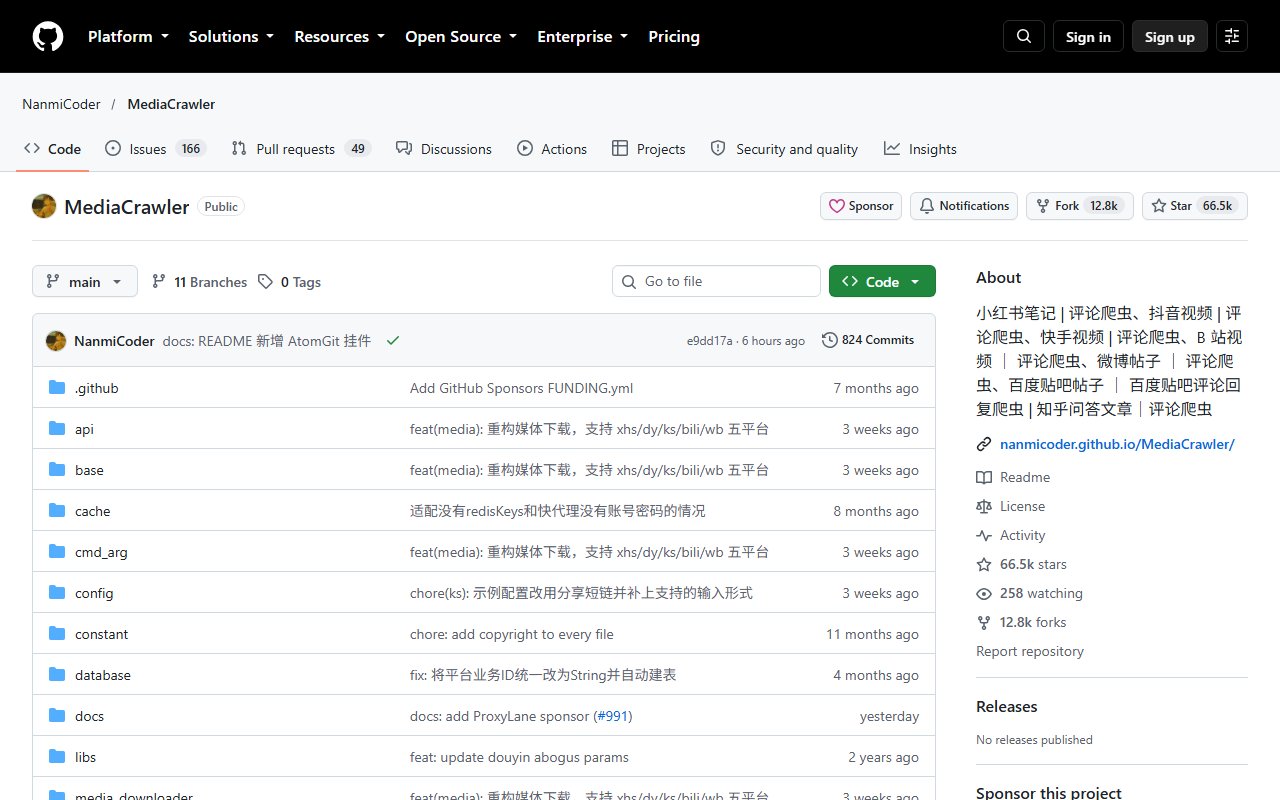
MediaCrawler 把小红书、抖音、快手、B站、微博、贴吧、知乎七个平台的公开内容收进同一套 Python 框架:关键词搜索、指定帖子、二级评论、创作者主页、评论词云,五种模式覆盖大多数调研场景。
它最值钱的设计是绕开了 JS 逆向——用 Playwright 起一个真实浏览器登录,平台给的签名参数直接就是对的。逆向脚本每逢平台改版集体阵亡的日子,这套方案照样能跑。
02仓库健康度
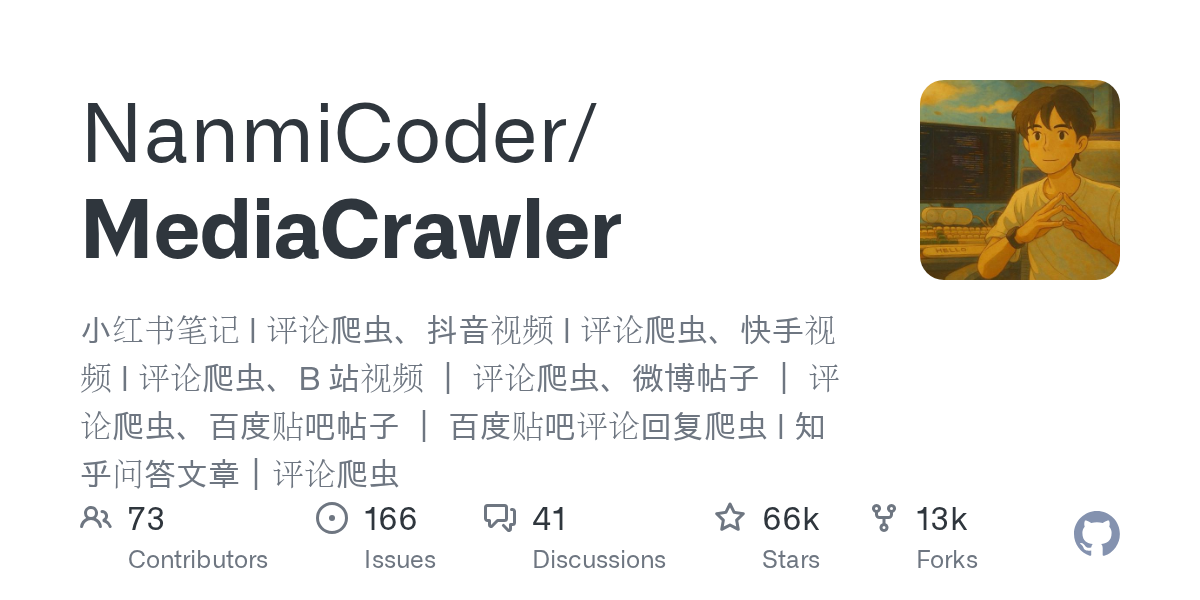
维护节奏在同类爬虫项目里属于第一梯队——这一行的项目普遍活不过平台三次改版,它活了三年。
03核心能力
- 七平台一套配置:换 platform 参数即换平台,抓取与存储逻辑统一封装
- 五种抓取模式:关键词搜索、指定帖子、二级评论展开、创作者主页全量、评论词云
- 免 JS 逆向:Playwright 持久化登录态,签名参数从真实浏览器会话里拿
- 词云直出:评论区抓完直接出图,省掉一步预处理
- 存储可插拔:CSV / JSON / 数据库,按调研口径选落库方式
04同类对比
单平台逆向脚本(小红书签名、抖音 a_bogus 那一类)跑得快,但平台一改算法就得重啃;商用采集服务稳定,但按条收费,数据来路要自己掂量。
MediaCrawler 选了中间路线:慢一点、吃资源,但签名跟着真实浏览器走,平台改版后的修复成本从「重新逆向」降到「升级依赖」。对调研这种跑一次歇几天的场景,这笔账是划算的。
05亮点
- 七平台全包:中文主流内容平台一个仓库覆盖,多数同类只做单平台
- 二级评论完整展开:评论区洞察最缺的就是楼中楼,它默认给你抓全
- 协议写明白:仅限学习研究、禁商用,边界清楚,用起来心里有数
06谁在生产用它
选题调研的内容团队、拆对标账号的自媒体、做舆情与市场研究的分析岗,以及拿公开评论做语料的学术工作。
说句实在的:因为协议禁商用,它很少作为公司生产系统的依赖出现,更多是「调研报告背后的那把铲子」——铲子不署名,但坑是它挖的。
07快速上手
前置:Python 3.9+,会改一处配置文件就够。
$ git clone https://github.com/NanmiCoder/MediaCrawler
$ cd MediaCrawler
$ pip install -r requirements.txt
# 编辑 config/base_config.py:选平台、填关键词
$ python main.py --platform xhs --type search
首次运行扫码登录一次,登录态落盘,之后不用再扫。
官方协议明确:仅限学习研究,禁商用。大规模、高频采集会触发平台风控,账号被限制是常事,合规与风险自担。想拿它搬运变现的路线别碰——这条线踩的不是技术坑,是法律坑。
09适合谁
做选题调研的内容工作者;学爬虫、想看正经工程实践的 Python 开发者;需要评论区公开语料的研究者。
要商用数据的公司(协议不允许);追求大规模持续采集的团队(风控与协议双重红线)。