
5MB 单文件跑本地大模型,OpenAI 接口完全兼容,4G 显存能跑 3B。给工具换个 baseURL 就能用,注意八月后无新提交。
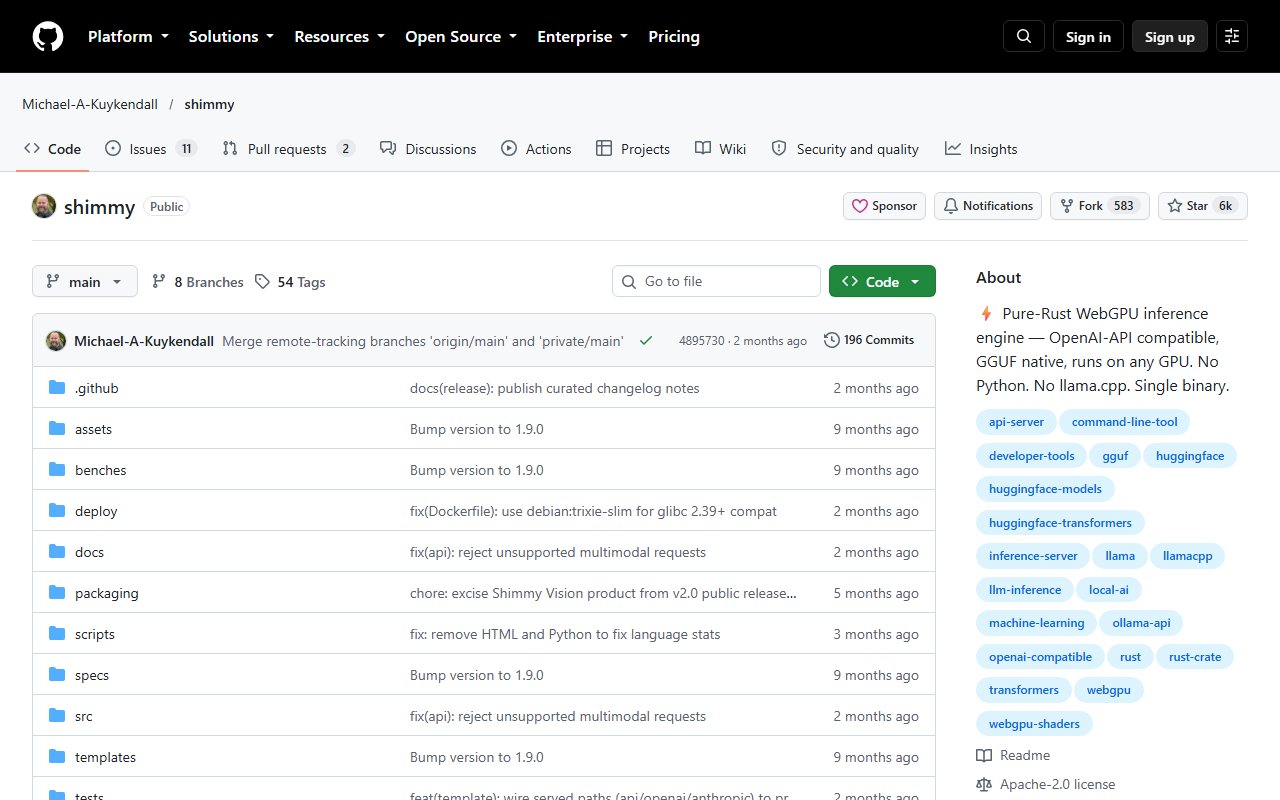
shimmy 是一个 5MB 的单文件本地推理服务:纯 Rust + WebGPU,一个二进制跑起来就是一个 OpenAI 兼容接口。你手头所有要填 OpenAI baseURL 的工具——编辑器插件、CLI 脚手架、RAG 管线——把地址指过去,本地模型即刻上岗。
资源账也好算:内存开销 38~50MB,约 7× KV 缓存压缩,4GB 显存就能跑 3B 模型;N卡、A卡、集显、苹果芯片通吃,GGUF 原生加载,26 个认证模型组合开箱即用。唯一要记住的是:八月之后,仓库没有新提交了。
02仓库健康度
放缓不是判死刑——单文件、零依赖、接口兼容,这类工具的生命周期天然比迭代型项目长。
03核心能力
- OpenAI 100% 兼容:现有工具换 baseURL 即接入,代码一行不改
- 单二进制:纯 Rust + WebGPU,5MB,没有 Python 环境、没有依赖地狱
- 显存友好:约 7× KV 缓存压缩,4GB 显存跑 3B,内存开销 38~50MB
- 硬件通吃:GGUF 原生,N卡/A卡/集显/苹果芯片都行,26 个认证模型组合
04同类对比
Ollama 和 LM Studio 是本地推理的两座大山:模型库全、生态熟,但各自带一套运行时和交互习惯,接进已有工具链多少要动手术、改调用方式。
shimmy 的卖点就一句话:给已有工具换个 baseURL 即用,零侵入。它不抢「模型管理器」的位置,只做管线里那个安静的推理端点。你已有的工具越多,这个定位越值钱。
05亮点
- 5MB 单文件:本地推理工具里罕见的体积,拷过去就是部署
- 4GB 显存跑 3B:约 7× KV 缓存压缩,低配机器也能上本地模型
- 零侵入接入:OpenAI 接口完全兼容,接入成本和换走成本一样低
06谁在生产用它
给内网工具补一个本地模型端点的后端、显存吃紧还想跑 3B 的独立开发者、数据不出内网的隐私敏感场景——凡是已经有一堆工具等着接模型的地方,都有它的位置。
说句实在的:它最适合当「管线里的零件」而不是「平台」。零件不需要频繁更新,这恰好对冲了它放缓的风险。
07快速上手
前置:一块显卡(任意品牌)或苹果芯片,一个 GGUF 模型文件。
$ git clone https://github.com/Michael-A-Kuykendall/shimmy
# 或从 GitHub Releases 直接取 5MB 单文件
# 工具里把 OpenAI baseURL 指向本地端口,即换即用
OpenAI 接口完全兼容,现有 SDK 不用改一行;GGUF 原生加载,26 个认证模型组合开箱即用。
8 月底后暂无新提交,选型前评估维护风险;本地推理赛道迭代快,长期项目建议留备选。但 OpenAI 兼容接口意味着换走成本低——这正是它敢放缓的资本:哪天要撤,把 baseURL 改回去就是。
09适合谁
已有工具链想低成本接本地模型的后端与独立开发者;显存 4GB 也要跑 3B 的低配机器;数据不出本机的隐私场景。
追最新模型、最新量化的追新党(更新停了);想要模型管理全家桶的(它只做推理端点)。